Čo je
okt 20. 2026
Keď si AI myslí, že rozumie obrázkom a textu: čo (ne)vedia moderné multimodálne modely
Predstavte si, že AI modelu, ako je ChatGPT, ukážete obrázok dievčaťa, ktoré beží po moste, a ponúknete mu niekoľko viet. Úloha je jednoduchá: vyber tú, ktorá obrázok najlepšie opisuje.
„Dievča beží po moste.“
„Muž stojí na pláži.“
„Pes spí na gauči.“
Pre dnešné modely je to úplná hračka. Úspešnosť na takejto úlohe sa blíži k sto percentám. Zdalo by sa teda, že problém „porozumenia obrázkom a textu“ je prakticky vyriešený.
Lenže čo ak im nedáme tri možnosti, ale desať, sto či tisíc? A čo ak medzi nimi budú vety, ktoré majú veľmi podobný význam, ako napríklad „Žena beží po ceste“, „Osoba stojí na moste“ alebo „Muž beží do kopca“?
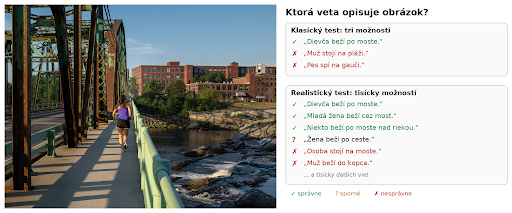
Obrázok 1: Úvodný príklad. Pri troch veľmi odlišných vetách je výber jednoduchý. Medzi tisíckami podobných viet, z ktorých sú niektoré správne, niektoré sporné a niektoré nesprávne, už nie. Foto: Jules Verne Times Two, Wikimedia Commons, CC BY-SA 4.0.
Tu sa zrazu ukáže, že overovanie schopností AI modelov je oveľa zložitejšie, ako sa môže na prvý pohľad zdať.
Práve tomuto rozdielu medzi „porozumenie obrázkom a textu je vyriešené“ a „v skutočnosti majú multimodálne modely ešte ďaleko od úplného porozumenia a prepájania obrazu a textu“ sa venoval môj doktorandský výskum.
O čom je tento projekt?
Na tejto téme pracujem už päť rokov ako doktorandka v KInITe (náš doktorandský program funguje v spolupráci s Fakultou informačných technológií VUT v Brne). Posledných šesť mesiacov tento výskum podporilo PwC Slovensko, aby som v ňom mohla pokračovať, a tento blog je krátke zhrnutie toho, čo som dosiahla. Oficiálny názov mojej dizertácie je „Porozumenie a ukotvenie multimodálnych obrazovo-jazykových modelov“. Zjednodušene povedané: prepája model, ktorý „vidí a číta“, obe veci naozaj? A ako by sme to vôbec mohli zistiť a testovať? Časť môjho výskumu bola podporená spoločnosťou PwC Slovakia a tento blog je stručným zhrnutím toho, čo sa mi podarilo dosiahnuť.
Čo sú vlastne modely, ktoré „vidia a čítajú“?
V posledných rokoch sa objavili multimodálne tzv. vision-language modely – modely, ktoré dokážu pracovať naraz s obrazom aj textom. Patrí sem napríklad CLIP, BLIP-2 či novšie multimodálne verzie veľkých jazykových modelov ako GPT-4, GPT-5, Gemini alebo Qwen.
Pod kapotou to robia dvoma spôsobmi. Prvý typ, napríklad CLIP, premení obrázok aj vetu na číselnú reprezentáciu – na vektory v rovnakom „priestore významov“. Ak je veta dobrým opisom obrázka, ich vektory sú blízko seba. Ak nie, sú ďaleko. Druhý typ, generatívne modely ako GPT-4 alebo Qwen, rozdelí obrázok na malé časti, premení ich na „vizuálne slová“ a pošle ich do jazykového modelu spolu s textom. Model potom odpovedá slovami: obrázok opíše alebo povie, či k nemu daná veta sedí. (S trochou dotrénovania sa dá generatívny model premeniť aj na ten prvý typ, čo sme v niektorých experimentoch urobili.) V oboch prípadoch sa vieme spýtať to isté: tu je obrázok a tu je pár viet, ktorá sedí najlepšie?

Obrázok 2: Dva spôsoby, ako prepojiť obrázok s textom. Embedding modely (vľavo) umiestnia obrázok aj vety do jedného spoločného priestoru, kde vzdialenosť hovorí, ako dobre veta sedí. Generatívne modely (vpravo) premenia obrázok na „vizuálne slová“, prečítajú ich spolu s textom a odpovedajú slovami.
Vďaka tomu multimodálne modely napríklad vedia:
- vyhľadávať obrázky podľa textu (napríklad vyhľadávanie obrázkov na Googli) alebo naopak,
- generovať popisy,
- odpovedať na otázky o obrázku,
- alebo lokalizovať objekty na obrázku.
Na papieri vyzerajú veľmi presvedčivo. Na štandardných benchmarkoch (testovacích súboroch dát) dosahujú vysoké čísla a dobré hodnotenia. A práve tu sa začalo moje skúmanie tohto problému: naozaj tieto modely rozumejú tomu, čo vidia – alebo len hrajú šikovnú štatistickú hru?
Problém: testovali sme ich príliš jednoducho
Keď som začínala doktorandské štúdium, väčšina testov na skúmanie porozumenia modelov fungovala takto:
Dáme modelu obrázok a dve vety:
- jedna správna,
- jedna úmyselne nesprávna (napr. zmeníme len podmet alebo len sloveso vo vete).
Model má vybrať správny opis.

Obrázok 3: Obrázok z datasetu SVO-Probes. V klasickom teste stačí, aby model uprednostnil správny popis „A person walking on a trail“ (Osoba kráča po chodníku) pred jedným upraveným: „A person runs on the trail“ (Osoba beží po chodníku). (Zdroj: náš článok na SOFSEM 2025)
To je trochu ako skúšať študenta z dejepisu otázkou:
Začala druhá svetová vojna v roku 1945 alebo 1545?
Ak odpovie správne, neznamená to, že sa naučil dejepis. Len to, že vie, ktorá možnosť je očividný nezmysel. Okrem toho, prečo sa v otázke vyskytuje práve 1545 a nie 1845, alebo dokonca 1946? Je totiž možné, že keby sme študentovi dali možnosti 1945 a 1545, vybral by si správny rok, pri možnostiach 1945 a 1845 by už mohol zaváhať a pri možnostiach 1945 a 1946 by si pokojne mohol vybrať nesprávny.
Podobne fungujú aj mnohé AI benchmarky. Netestujú model na všetkých nesprávnych možnostiach, pravdepodobne ani na tých, ktoré pre modely predstavujú najväčšie výzvy. Model sa naučí odlíšiť extrémy, ale nevieme, čo by robil v reálnom svete, kde sú možnosti oveľa podobnejšie.
Od dvoch možností k celej databáze
Vo svojom výskume som preto zmenila perspektívu.
Namiesto „Pre daný obrázok vyber správny text z dvoch možností“ som sa začala pýtať „Z celej databázy tisícok viet, ktorých 10 je podľa teba najpodobnejších tomuto obrázku?“
Táto úloha sa volá retrieval (vyhľadávanie).
Je to realistickejší scenár – presne tak fungujú vyhľadávače obrázkov alebo multimodálne databázy.
A tu sa začali diať zaujímavé veci.
Keď vysoké skóre klame
Na klasických testoch s dvoma možnosťami vybrali skúmané modely správnu vetu zhruba v deviatich prípadoch z desiatich. Vyzeralo to skvelo.
Potom sme im však dali skutočnú úlohu: pre daný obrázok nájsť zodpovedajúcu vetu medzi tisíckami kandidátov. Úspech sme teraz počítali len vtedy, keď bola hneď prvá veta, ktorú model vrátil, presne tá, ktorá bola k obrázku napísaná. A zrazu modely uspeli len zhruba v jednom prípade z desiatich.
Model väčšinou našiel „niečo podobné“, ale pomýlil si aktivitu alebo vzťah medzi objektmi.
Čo nás prekvapilo ešte viac: najťažšie nesprávne odpovede neboli tie, ktoré pre benchmark niekto ručne napísal, ale tie, ktoré si modely samy vybrali z databázy.

Obrázok 4: Rovnaký dopyt („A person walks down a road towards a motorcycle“, Osoba kráča po ceste smerom k motorke), traja kandidáti. (a) Správny obrázok; (b) ručne vytvorený nesprávny obrázok z benchmarku, v ktorom sa zmenil objekt; (c) nesprávny obrázok, ktorý si modely samy našli vo svojej top 10: cesta aj motorka tam sú, ale dej je iný. Päť zo šiestich testovaných modelov zaradilo (c) nad správny obrázok. (Zdroj: naša práca v recenznom konaní)
Typické chyby:
- správna osoba, ale zlá činnosť,
- správna činnosť, ale zlý objekt.
Ukázalo sa, že:
- subjekty (kto?) sú pre modely najľahšie,
- objekty (koho? čo?) sú oveľa ťažšie,
- slovesá a vzťahy (čo robí?) sú ešte ťažšie.
Inými slovami – model vie, že je tam „človek“, ale už si nie je taký istý, čo ten človek robí. Siahne po činnosti, ktorá je pre daný subjekt a prostredie najpravdepodobnejšia (na ceste nikto nepláva, v parku väčšinou takmer nikto nespí a na pláži sa tancuje len občas).
Pre reálne aplikácie je to dosť zásadný problém.
Ďalší háčik: nie všetky „chyby“ sú naozaj chyby
Pri retrievale sa objavil ešte jeden zaujímavý efekt.
Pozrite sa na obrázok zo začiatku tohto blogu s vetou: „Dievča beží po moste.“
Model vráti: „Žena beží po ceste.“
Je to zle? Alebo vlastne… celkom dobrá odpoveď?
Klasické metriky to označia ako chybu, lebo veta nie je presne tá, ktorú sme podľa datasetu hľadali.
Lenže sémanticky je úplne v poriadku.
Preto sme zaviedli:
- ľudských anotátorov,
- a dokonca aj ďalší veľký model ako „rozhodcu“.
Výsledok? Skutočná úroveň bola často omnoho lepšia, než naznačovali tvrdé čísla. Podľa ľudského hodnotenia bol prvý výsledok správny zhruba pri približne piatich až deviatich dopytoch z desiatich, v závislosti od modelu.
To ukazuje, že hodnotiť AI je niekedy ťažšie než ju trénovať.
Model ako sudca
Prečo by sme vôbec chceli využiť AI model na vyhodnocovanie iného AI modelu? Lebo ľudské anotácie sú drahé a my sme chceli vedieť hodnotiť nové modely na nových datasetoch aj bez ľudskej sily.
Jeden príklad z našej práce: na kontrolu jediného datasetu sme vzali 100 dopytov a desať výsledkov, ktoré pre ne vrátil každý model. Vyšlo z toho približne 3 000 dvojíc obrázok – popis. Každú dvojicu posudzovali traja ľudia, teda dokopy zhruba 9 000 rozhodnutí. Aj pri desiatich sekundách na dvojicu je to pre každého anotátora viac než celý pracovný deň. A je to presne taká nuda, ako to znie: pozrieť sa na obrázok, prečítať vetu, kliknúť áno alebo nie. A znova. A znova. Tisíckrát. Pri ďalšom modeli alebo ďalšom datasete začínate od nuly.
Preto sme si nechali pomôcť modelom. Keď máme pre dopyt desať vyhľadaných výsledkov, spravíme z nich desať dvojíc: dopyt s prvým výsledkom, dopyt s druhým výsledkom a tak ďalej až po desiaty. Z každej dvojice sa tak stane jednoduchá otázka: „Sedí tento obrázok k tomuto popisu? Ak nie, čo nesedí – subjekt, sloveso alebo objekt?“
Posúdiť jednu dvojicu je oveľa ľahšia úloha než prehľadávať tisíce kandidátov a, ako už vieme, najsilnejšie dnešné modely ju zvládajú veľmi dobre. Dvojice sme preto dali najlepšiemu dostupnému modelu a nechali ho rozhodnúť.
Pre istotu sme jeho verdikty porovnali s verdiktmi ľudských anotátorov na rovnakých dvojiciach. Zhoda bola vysoká. Nie celkom taká, akú majú ľudia medzi sebou, ale bolo to blízko.
To otvára cestu k lacnejšiemu a škálovateľnému hodnoteniu veľkých datasetov.
Kto koho pohrýzol?
V najnovšej práci som išla ešte o krok ďalej. Najťažší test toho, či model rozumie deju, je vymeniť účastníkov: z „Pes hryzie ruku“ sa stane „Ruka hryzie psa“. Dnešné veľké modely prejdú týmto testom asi v deviatich prípadoch z desiatich. Keď však ten istý model požiadame, aby nám na obrázku ukázal „toho, kto hryzie“, bez toho, aby sme ho pomenovali, nájde oboch účastníkov len zhruba v tretine až polovici prípadov. Znova sa teda ukazuje, že úspech v teste zhody obrázka a popisu nedokazuje, že model naozaj rozumie obrázku aj textu.

Obrázok 5: Model uprednostní popis „A dog bites a hand“ (Pes hryzie ruku) pred „A hand bites the dog“ (Ruka hryzie psa). Keď ho však požiadame, aby ukázal „toho, kto hryzie“, označí človeka (oranžová), a keď sa pýtame na „to, čo je hryzené“, označí psovi papuľu. Modré rámčeky sú správne odpovede. (Zdroj: naša práca v recenznom konaní)
Čo z toho plynie?
Hlavné zistenie môjho výskumu je jednoduché, ale trochu nepríjemné:
Vysoké skóre na benchmarkoch ešte neznamená, že model naozaj rozumie.
Modely:
- sú dobré v hrubom rozpoznávaní objektov a ľudí,
- ale slabšie v jemných vzťahoch a akciách,
- a klasické testy tieto slabiny maskujú.
Preto popri iných možnostiach navrhujeme hodnotiť modely aj „pomocou vyhľadávania“ – pozerať sa na ich top výsledky a analyzovať chyby.
Je to trochu ako namiesto testu s výberom odpovede sledovať, ako sa človek správa v reálnom svete.
A kde to má využitie?
Tieto zistenia nie sú len akademická hra.
Týkajú sa:
- vyhľadávania obrázkov,
- moderovania obsahu,
- multimodálnych asistentov,
- ale aj fact-checkingu a práce s multimodálnymi informáciami.
Ak model zle pochopí „kto čo robí komu“, môže to viesť k nesprávnym záverom – napríklad pri analýze správ alebo dezinformácií.
Preto potrebujeme modely nielen väčšie, ale aj lepšie testované.
Čo z môjho výskumu vzniklo
V konkrétnych číslach: z výskumu vzišli tri publikované články, štyri práce momentálne v recenznom konaní a verejne dostupný dataset aj kód.
- Guided masking (SOFSEM 2025). Nová metóda skúmania multimodálnych modelov. Namiesto výberu z dvoch popisov v popise skryjeme jedno slovo a necháme model, aby ho doplnil. V tomto teste rozumeli staršie modely slovesám lepšie, než naznačovali benchmarky s dvoma možnosťami.
- CV-Probes (CogSci 2025, spolu s Univerzitou v Utrechte). Dataset a štúdia, ktorá porovnáva slovesá vyžadujúce sociálne znalosti, ako „žobrať“ alebo „modliť sa“, so slovesami, ktoré sa dajú vyčítať priamo z obrázka, ako „sedieť“ alebo „kľačať“. Modely sú pri prvej skupine výrazne slabšie a samotnému slovesu v popise venujú len malú pozornosť.
- Hodnotenie cez vyhľadávanie (v recenznom konaní). Existujúce benchmarky preformulujeme na vyhľadávacie úlohy, najlepšie výsledky necháme posúdiť ľuďom aj jazykovým modelom a zverejňujeme anotované dáta spolu s celým postupom, aby sa rovnakým spôsobom dali otestovať aj ďalšie modely.
- Test „kto čo komu robí“ (v recenznom konaní). Štúdia o tom, čo úspech v štandardnom teste s vymenenými rolami dokazuje a čo nie o tom, ako model rozumie deju.
- Využitie pri overovaní faktov. Rovnaké know-how o vyhľadávaní sme využili v systémoch, ktoré priraďujú príspevky zo sociálnych sietí k už overeným tvrdeniam (ICMR 2025), a v metóde, ktorá premení všeobecný vision-language model na výkonný vyhľadávač overených tvrdení len s ľahkým dotrénovaním (v recenznom konaní).
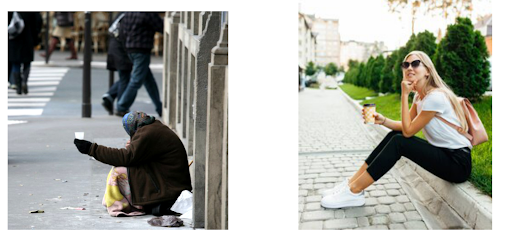
Obrázok 6: Dva obrázky z datasetu CV-Probes. Popis „Žena sedí na ulici s pohárom v ruke“ sedí na obe fotografie, ale „Žena žobre o peniaze na ulici“ len na ľavú. Rozlíšiť ich vyžaduje sociálne znalosti, nielen to, čo je vidieť. (Zdroj: náš článok na CogSci 2025)
Osobná poznámka z PhD
Jedna vec, ktorú som si počas doktorátu uvedomila, je, že v AI je veľmi ľahké naháňať čísla. Zvýšiť presnosť o jedno percento. Pridať väčší model. Viac dát.
Ale niekedy je dôležitejšie zastaviť sa a spýtať:
- „Čo vlastne tie čísla znamenajú? Meriame naozaj to, čo si myslíme, že meriame?“
Veľká časť môjho výskumu nebola o tom, ako urobiť model lepším, ale o tom, ako urobiť hodnotenie poctivejším. A paradoxne, práve to nám často najviac odhalí, čo modely ešte stále nevedia.
Ďakujeme Nadačnému fondu PwC v Nadácii Pontis za finančnú podporu tohto výskumu!